
LLM Guide / 学习笔记 · 更新于 2026-09-23
意图识别:从一句话到多轮状态
保留四版方案图,补上多轮槽位更新、话题切换与评估。
GitHub 初稿 ↗“换一个”可以是在换推荐商品,也可以是在改收货地址。只看这三个字,分类器没有足够信息。意图识别除了给当前句子贴标签,还需要知道用户正在做哪件事,以及这一轮改了哪些条件。
下面保留四版方案的结构图,并把每次拆分与合并的代价写清楚。图里的模型名称对应当时的方案记录,不构成当前选型推荐。
先把输出约定好
以虚构的购物对话为例,用户先说“想买两千以内的降噪耳机”,后面补充“不要入耳式”。合理结果应保留预算,追加佩戴形式限制,而不是建立一个与上一轮无关的新任务。
{
  "intent": "product_search",
  "topic_action": "continue",
  "slots": {
    "category": "headphones",
    "budget_max": 2000,
    "excluded_form": ["in_ear"]
  },
  "missing_slots": [],
  "evidence": ["两千以内", "不要入耳式"]
}
evidence 保存简短原句或消息引用,便于检查槽位从哪里来。没有必要让模型输出一大段内部推理。用户没说品牌时就留空,不能因为某个品牌常见就替他填进去。
一次识别意图和槽位
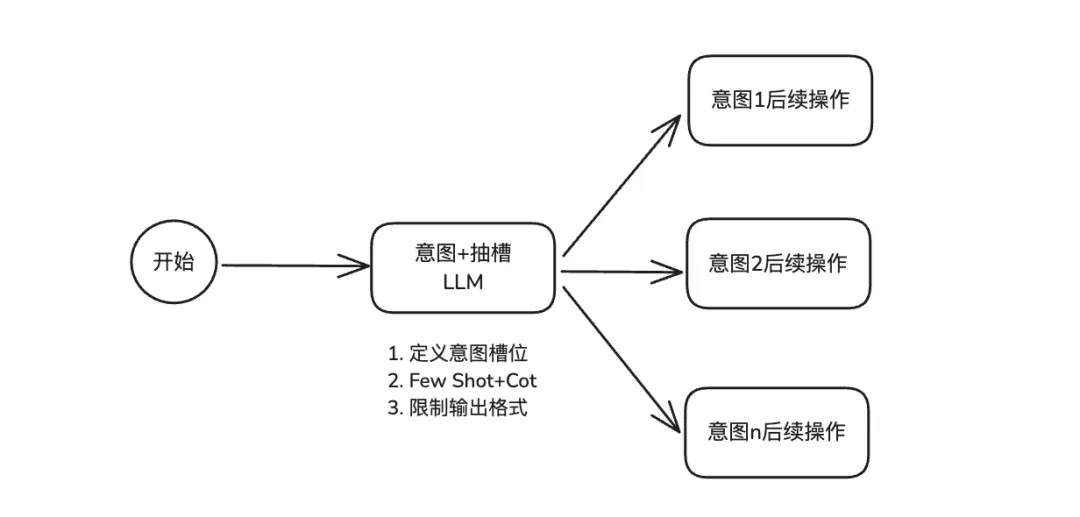
把意图定义、槽位和少量示例一起给模型,链路最短,适合先做基线。意图增加以后,提示词会膨胀,相似标签也更容易互相干扰。
延迟记录里的“3s 以上”缺少输入长度、网络和部署配置,暂时不能作为模型之间的比较依据。更值得记录的是输入 token、输出 token、端到端分位延迟,以及哪些意图被混淆。
把分类与抽槽拆开
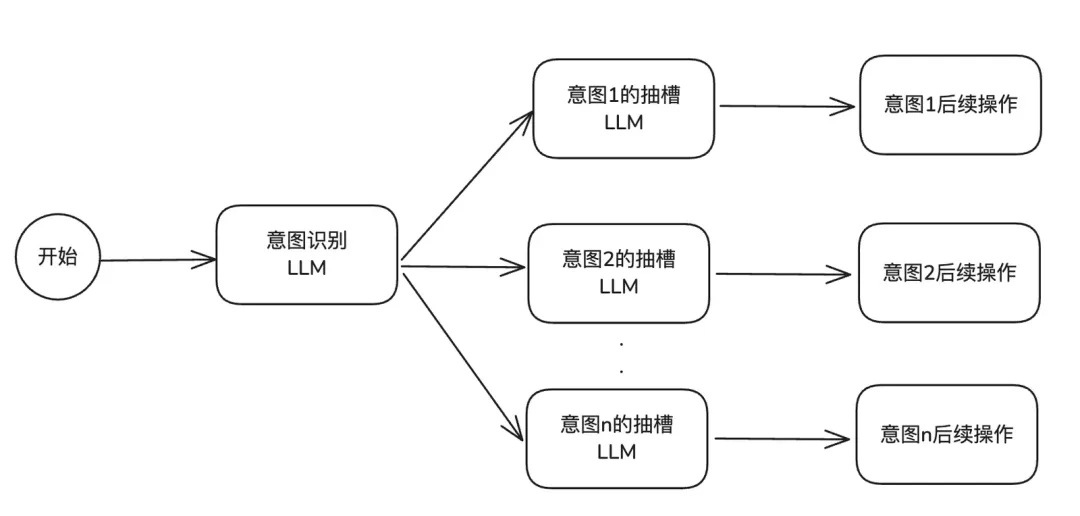
分类节点只需要理解意图边界,抽槽节点拿到所选意图的 schema。每个节点更容易维护,也方便为不同业务选择不同模型。
代价是串行调用变多。第一步分错了,第二步可能按照错误 schema 稳定地输出一个格式正确的结果。所以验证不能止步于“JSON 合法”,还要比较意图和整组槽位是否匹配用户需求。
用检索减少候选范围
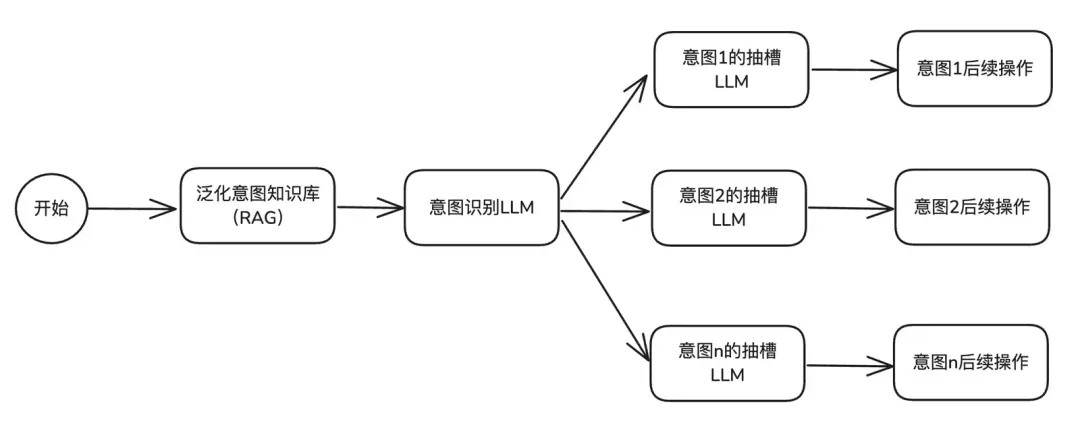
把意图定义、典型问法和易混淆案例存起来,先召回有限候选,再交给模型判断。遇到 bad case 可以补充案例,不必把所有内容都塞进固定提示。
这条路径也会增加一个失败点:正确意图如果没有被召回,后面的分类器就很难选对。评估时要单独测候选召回率,再看候选范围内的分类准确率。
检索结果最好同时包含相似意图的边界。例如“查询退款进度”和“申请退款”用词接近,但一个是在查已有流程,一个是在启动流程。只加更多同类正例,未必能解决这类混淆。
合并调用,显式管理话题
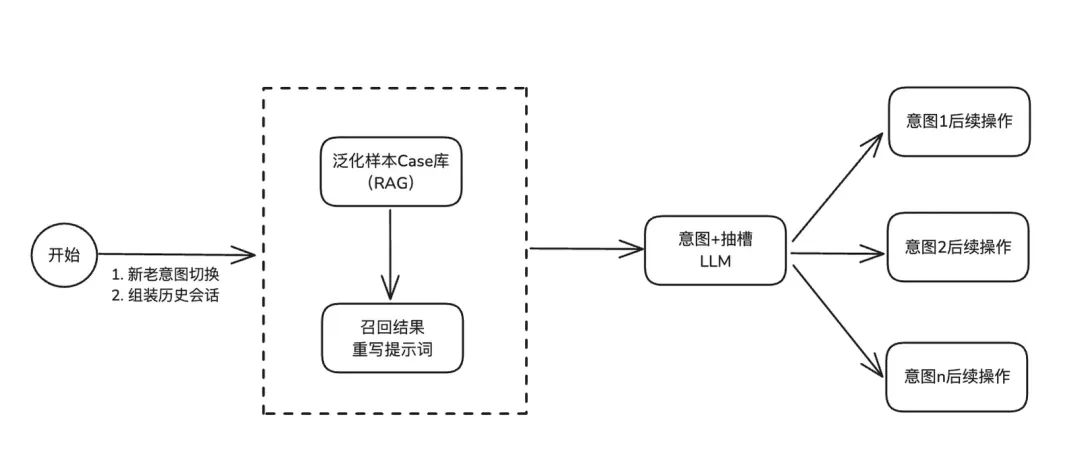
当前状态、最近几轮对话与召回案例一起输入,一次产出意图和槽位更新。状态更新需要区分 continue、revise 和 switch,实际项目也可以使用更适合业务的枚举。
“预算改成三千”是修改已有槽位;“算了,帮我看看冰箱”则可能切换话题。后一种情况不能把耳机的降噪要求带到冰箱搜索里。槽位删除也要有显式语义,不能把“这次没提到预算”理解成“清空预算”。
模型输出应先经过 schema 校验和业务规则,再合入状态。涉及订单、支付等实际动作时,意图标签只提供路由线索,不应单独作为执行授权。
留一份能反复跑的对话集
测试用例至少要包含省略主语、否定条件、预算改口、话题切换、同一句里两个需求,以及完全不在业务范围内的输入。按完整会话划分训练和测试数据,避免同一段对话的前后轮分别落到两边。
除意图准确率外,可以统计 macro-F1、每个槽位的准确性、整组槽位完全匹配率、澄清率和延迟。少数意图若总被大类吞掉,整体准确率仍可能很好看,混淆矩阵更容易暴露这种问题。
若输出一个“置信度 0.95”,还需要在标注数据上校准它。模型自己报出的数字不能直接解释成 95% 正确概率。证据不足时追问一句,往往比把含糊分类强行送往下游更容易收拾。
相关:RAG 中的多轮查询改写、长对话的状态保存。